در محیط Container Database، گاهی اوقات ممکن است یک PDB در مدت زمان کوتاهی مقدار بسیار زیادی Redo تولید کند. این تولید بیش از حد Redo میتواند منابع مشترک را مصرف کرده و بهطور بالقوه روی عملکرد سایر PDBها تأثیر بگذارد. به بیان دیگر، یک PDB میتواند مصرف بیش از حد منابع داشته باشد و عملکرد سایر PDBها را تحت تأثیر قرار دهد.
اوراکل 26ai در نسخه 23.26.3 پارامتر REDO_GENERATION_KBPS_MAX را در این زمینه معرفی کرده است. این پارامتر به ما اجازه میدهد مقدار نرخ تولید Redo یک PDB مشخص را کنترل کنیم و برای آن یک target تنظیم کنیم.
هنگامی که یک PDB از مقدار target تعیینشده عبور کند، اوراکل میتواند sessionهای مربوط به آن را محدود کند تا نرخ تولید Redo را نزدیک به محدوده تنظیمشده نگه دارد.
در ادامه این متن، برای آشنایی بیشتر با این قابلیت جدید، از یک عملیات ساده CTAS استفاده شده و زمان اجرای آن را در دو حالت، یعنی بدون محدودیت و با محدودیت تولید Redo، مقایسه کردم.
ابتدا عملیات را بدون هیچگونه محدویتی در زمینه تولید redo اجرا می کنیم:
SQL> create table tb2 as select * from tb1;
Table created
Executed in 18.315 seconds
این عملیات تنها در 18 ثانیه به پایان رسید. این session بیش از 719802 مگابایت Redo تولید کرده بود:
SELECT round(value / 1024 / 1024) REDO_SIZE_MB
FROM v$sesstat st
JOIN v$statname sn
ON sn.statistic# = st.statistic#
WHERE st.sid = 221
AND sn.name = 'redo size';

REDO_SIZE_MB
 - - - - - -
719802
این مقدار، baseline ما برای این workload است.
محدود کردن تولید Redo
برای نمایش این قابلیت جدید، تصمیم دارم تا این PDB را بهگونهای محدود کنم که اجرای عملیات CTAS فوق به جای 18 ثانیه، حداقل سه دقیقه به طول بینجامد. برای این منظور، یک redo_generation_kbps_max برابر با 4000 برای PDB تنظیم می کنیم:
SQL> ALTER SYSTEM SET redo_generation_kbps_max = 4000;
System altered
سپس جدولی که در مرحله قبل ایجاد شده را حذف و دقیقاً همان عملیات CTAS را دوباره اجرا می کنیم:
SQL> drop table tb2;
Table dropped

SQL> create table tb2 as select * from tb1;
Table created
Executed in 190.017 seconds
نتیجه کاملاً متفاوت است. همان عملیاتی که قبلاً به 18 ثانیه زمان نیاز داشت، با قابلیت جدید در 190 ثانیه انجام شده است. یعنی اجرای این عملیات بیش از 10 برابر کندتر شد و این اولین بار است که از کندی عملیات باید خوشحال باشیم.
در اجرای دوم عملیات CTAS نکته ای که بیشتر مورد توجه بود، wait event مربوط به session است که resmgr: redo throttle را نشان می داد:
SQL> select event from v$session_wait where sid=221;

EVENT
- - - - - - - - - - - - -
resmgr: redo throttle
گزارش AWR هم این نکته را تایید می کند:
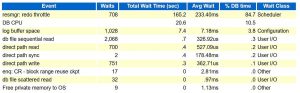
همانطور که در تصویر فوق مشاهده می کنید 84.7% از database time صرف resmgr: redo throttle شده بود.
این موضوع بهوضوح نشان میدهد که session بیشتر database time خود را در وضعیت throttled توسط Resource Manager سپری کرده است؛ زیرا از target تنظیم شده عبور کرده بود.
Vahid Yousefzadeh

ارائه خدمات مشاوره ، پشتیبانی و نصب و راه اندازی پایگاه داده اوراکل در سراسر کشور...................... تلفن: 09128110897 ایمیل:vahidusefzadeh@gmail.com